随着智能模型逐步进入自动驾驶、智能交通和公共安全等真实系统,对模型的评价正在从 " 测试集上的准确率 " 转向 " 开放环境中的可信性 "。目标检测模型承担着识别周围目标及其位置的关键任务,其输出还会被后续规划与决策模块使用。真实环境中的光照、天气、遮挡和场景构成不断变化,即使图像在视觉上仍然自然合理,也可能触发模型漏检、误检或定位偏差。因此,智能模型的可信性不仅体现为平均精度较高,更取决于其面对未知但合理的环境变化时,能否保持稳定、一致的判断。
在实际应用中,目标检测模型内部机制不可见、技术架构多样等特性,使其潜在失效模式难以在部署前被充分发现,进而面临不可预期的可信性风险。具体而言,真实部署的模型通常以封闭系统或在线服务的形式运行,测试人员无法访问模型参数和内部梯度;不同目标检测架构又分别依赖分类置信度、候选区域和边界框定位等不同机制,难以使用同一种方式刻画其失效。更重要的是,可信性测试需要构造一类特殊的 " 反事实场景 " :图像在语义和视觉上仍然符合真实世界,但模型的检测结果却发生明显错误。若测试样本包含突兀的补丁或噪声,模型失效可能只是由不真实输入造成;若变化过于保守,又难以触及模型真正依赖的脆弱特征。如何同时满足 " 能够暴露缺陷 " 与 " 保持真实自然 " 两项要求,是开展开放环境模型可信性评估的核心挑战。
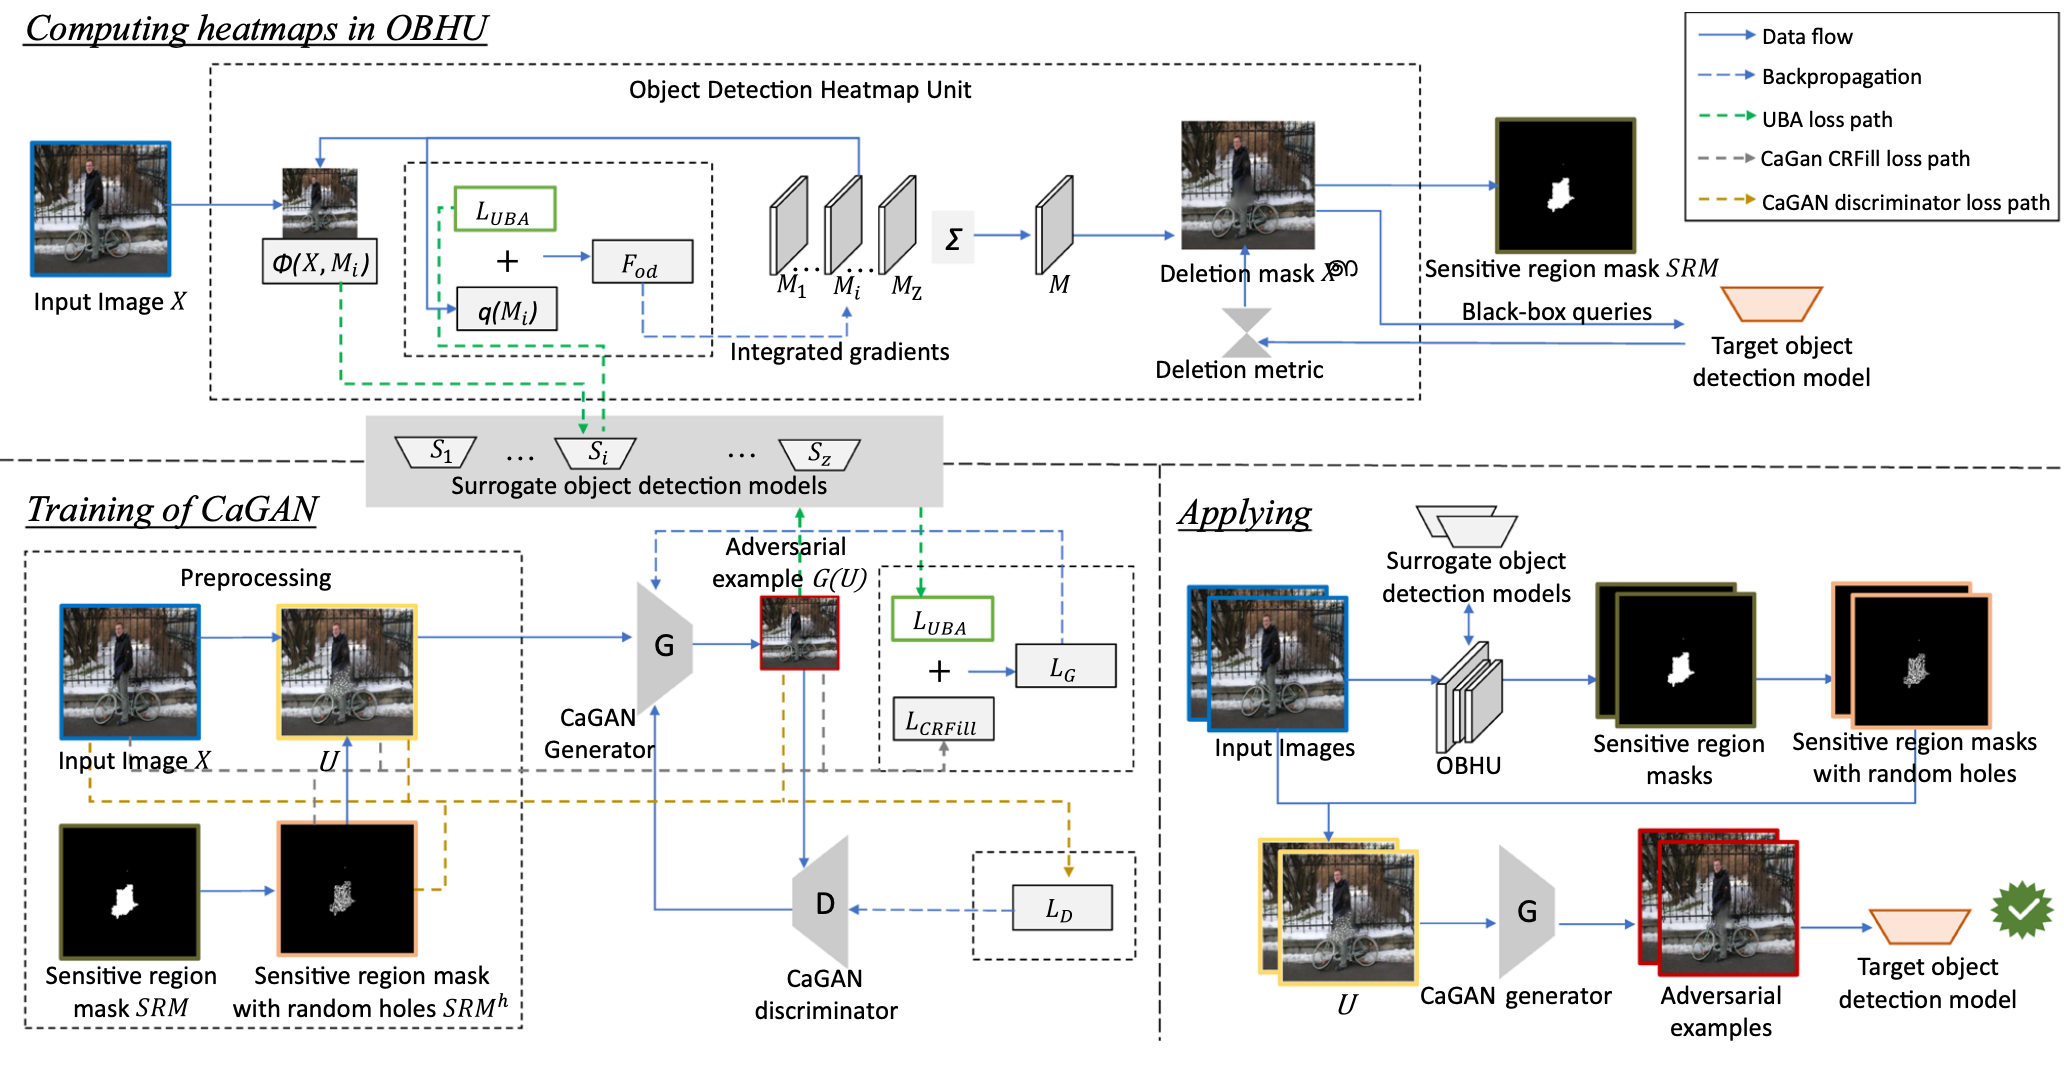
现有黑盒测试方法主要通过固定补丁或像素扰动影响模型输出,往往面向特定架构或单一检测指标,也难以兼顾测试有效性与图像自然性。针对这些局限,南京大学 iSE 实验室联合南京理工大学提出统一黑盒对抗测试方法 UBA。该方法不再围绕单一输出指标构造扰动,而是统一关联目标的分类、置信度和定位结果,刻画不同检测架构共同的失效语义;进一步通过可视化分析寻找真正支撑模型判断的关键区域,并利用周围场景对这些区域进行上下文重构,生成 " 场景依然合理、模型却发生错误 " 的高价值测试样本。实验覆盖 8 种主流目标检测模型和多个真实场景数据集,结果表明,UBA 生成的样本能够在不同模型架构之间稳定迁移,并在保持视觉自然性的同时更有效地暴露模型缺陷;利用这些样本进一步训练模型后,模型检测精度提升了 13.7 至 28.9 个百分点。该研究将对抗测试从人工噪声下的失效验证推进到语义合理变化下的脆弱性发现,为形成 " 风险发现 — 原因暴露 — 模型增强 " 的可信性保障闭环提供了新的技术路径。
相关成果 " UBA: A Unified Black-Box Adversarial Testing for Object Detection via Visualization-Based Contextual Reconstruction " 已发表于 CCF - A 类期刊《 International Journal of Computer Vision 》,并被收录于开放世界视觉识别可信性保障专题。论文第一作者为南京大学软件学院刘佳玮博士,主要研究方向为智能模型和算子的质量保障。该研究在前期智能模型测试工作的基础上,进一步融合可解释分析与上下文重构技术,为目标检测模型可信性测试从人工扰动下的失效验证走向真实语义场景中的风险发现与模型增强提供了重要参考。